[前言]
我所在的实践团队在洞庭湖做护鸟调研。在田埂上被农户问得最多的一个问题就是:「这是什么鸟?它吃我的鱼苗/谷子,我能赶它吗?」查资料不方便,问人又不一定认识。于是我们做了「青智护飞」这个小程序:拍一张照,返回鸟的种类、习性、食性,顺带把识别结果存成记录,方便事后回顾和科普。
网上讲「YOLO 训练识别」的教程很多,但把模型真正装进一个小程序闭环里的完整复盘很少——训练只是第一步,后面还有图片方向、中文名映射、用户记录、部署内存一大堆事。本文偏工程、不偏宣传,记录我在这个项目里实际踩过的坑和最终方案,希望对做类似「小程序 + FastAPI + YOLO」的同学有帮助。
线上体验入口(项目官网宣传页):https://bird.hnist.org.cn。小程序端所有识别结果都来自后端接口,前端没有任何硬编码鸟种列表,这点后面会细说。
说明:文章代码均已裁剪,域名、密钥等一律用占位符。生产配置请全部走环境变量,务必不要提交任何密钥。
一、整体长什么样:一次识别的完整流程
技术栈很朴素:
- 小程序端:TypeScript,glass-easel + Skyline 渲染,全页面用
Component()构造,两个 Tab(识鸟 / 我的); - 后端:FastAPI(
python:3.10-slim+ Docker),SQLite 存会话和识别记录; - 推理:YOLOv8 训练后导出 ONNX,用 ONNX Runtime(CPU)推理,不装 torch;
- 顺带:FastAPI 把
static/静态官网挂载到根路径/,/api/*路由优先匹配,一套域名搞定 API + 官网。
一次识别的完整链路是这样:
- 拍照/选相册图 → 前端读取 EXIF
orientation,压缩时顺便把方向校正掉,缩到最长边 1280 再上传; wx.uploadFile上传到/api/recognize(超时放宽到 60s,因为服务端可能要做多次推理,后面讲);- 服务端解码图片,再次
ImageOps.exif_transpose兜底方向; - 必要时做「方向探测」(见第三节),然后模型推理;
- 后处理输出
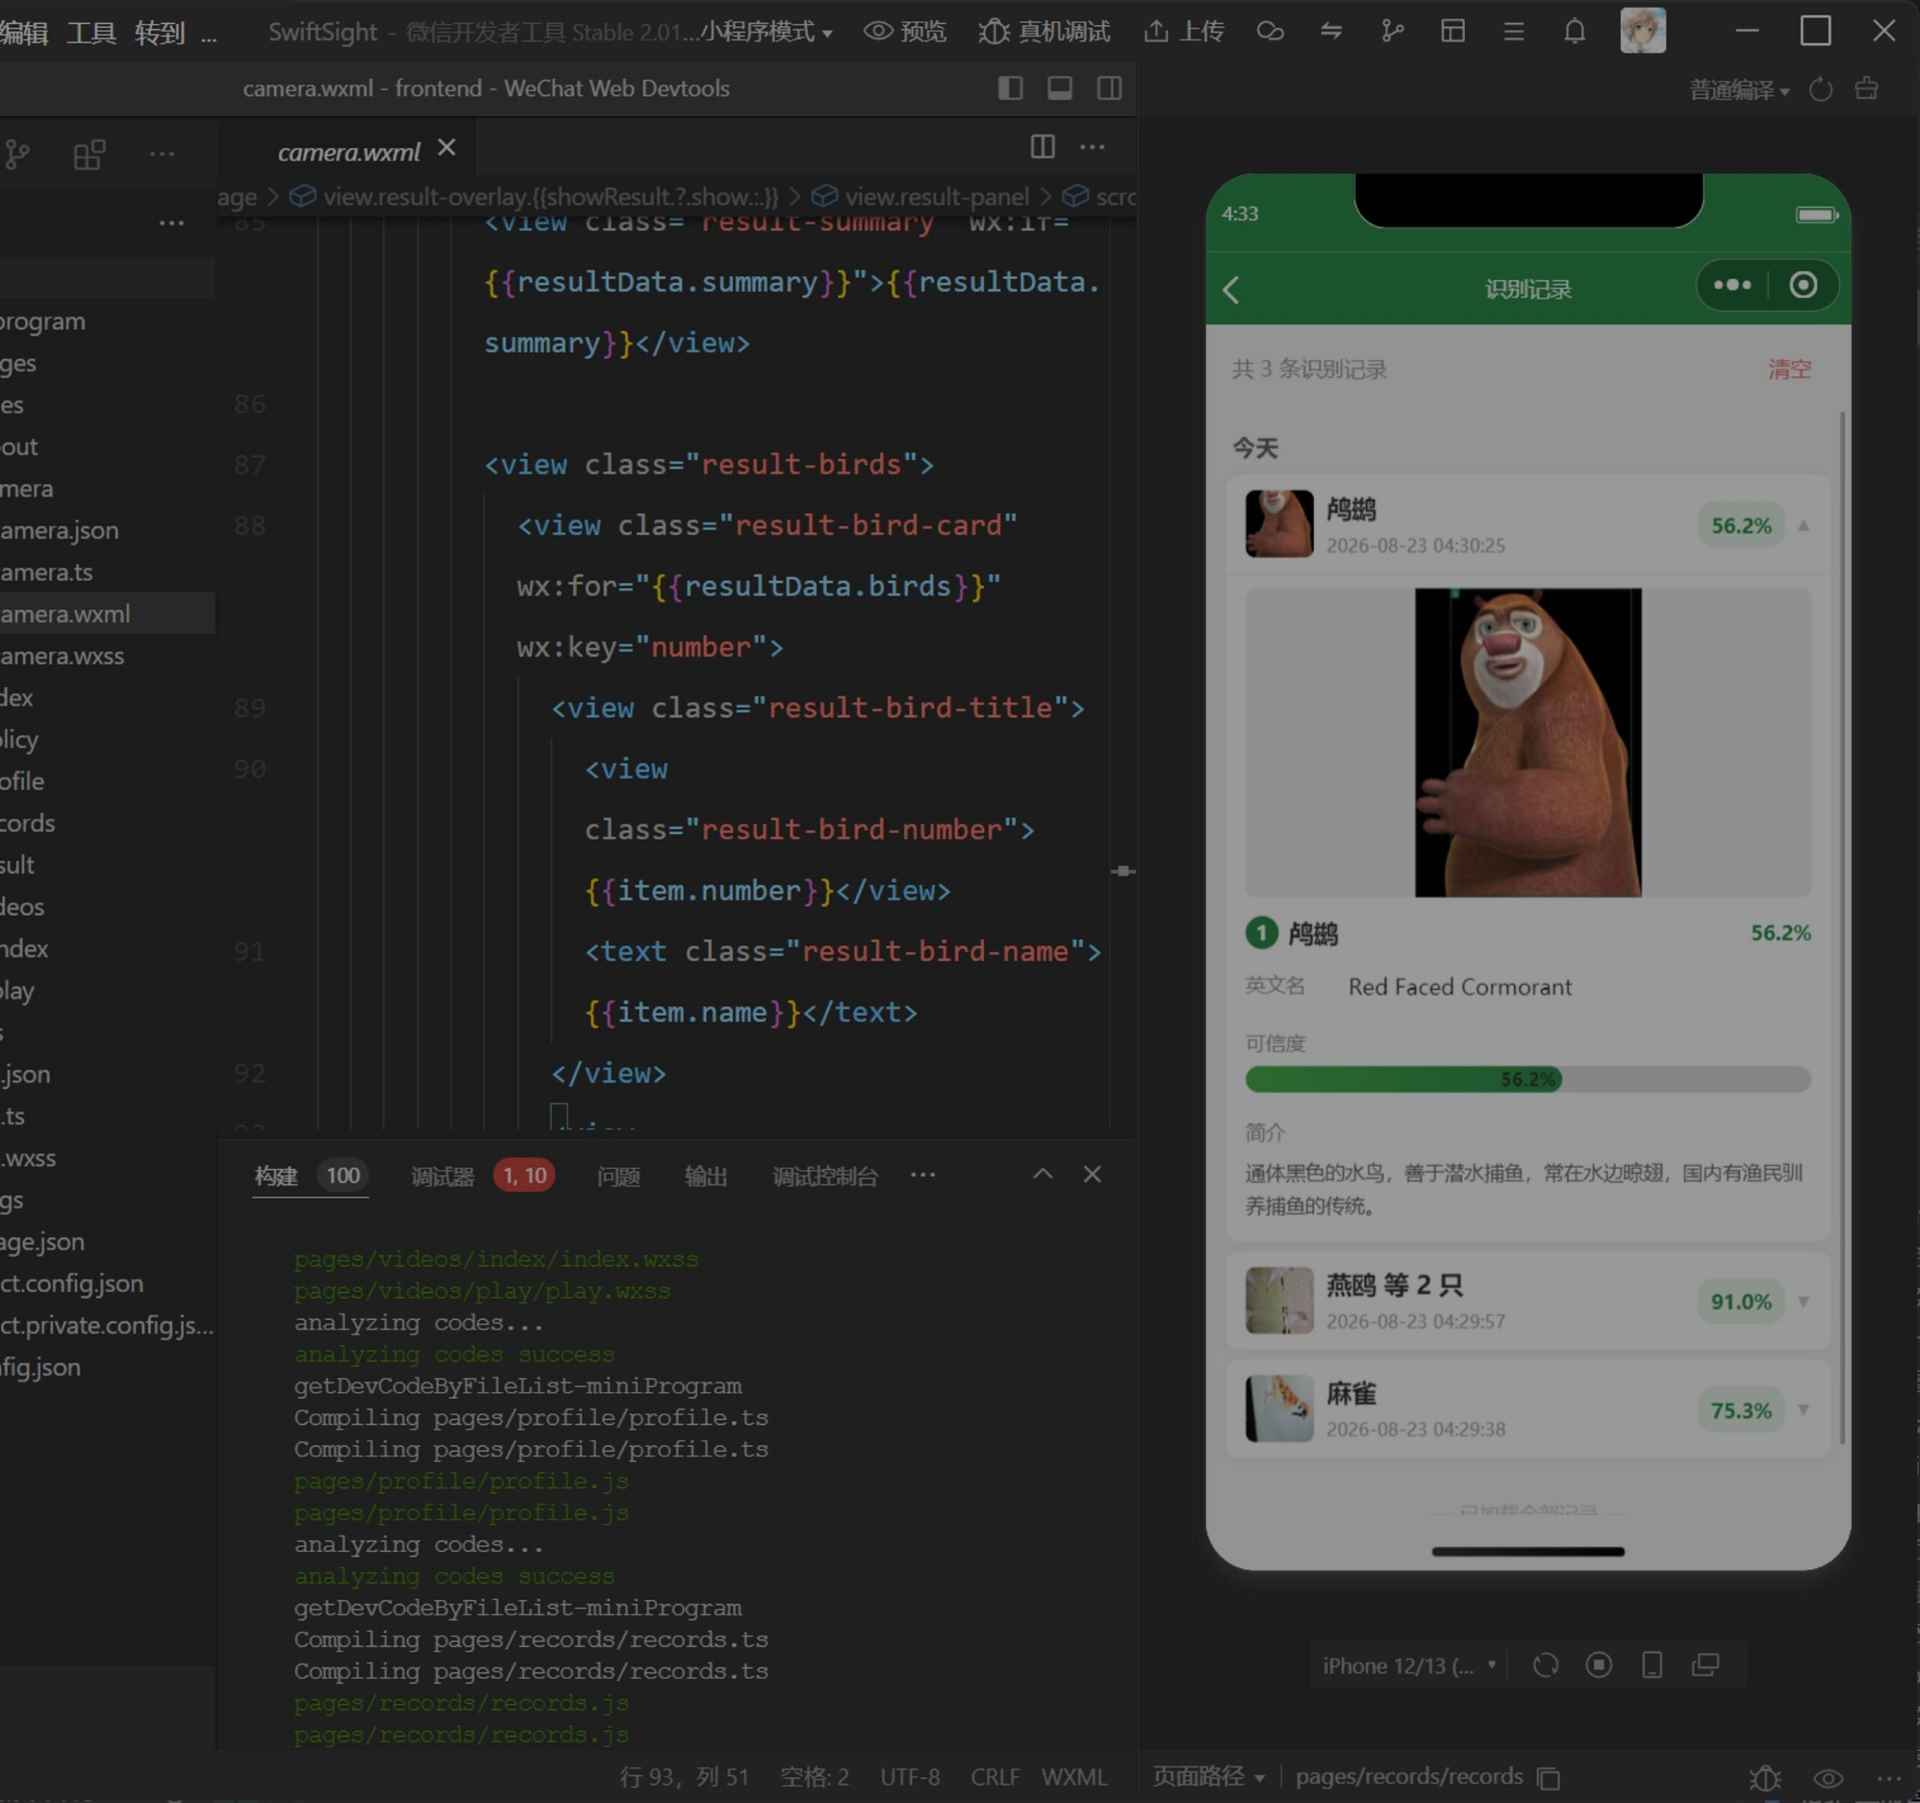
birds[],每只鸟带置信度和bbox坐标(原图像素坐标系),按置信度倒序; - 前端展示结果;用户点保存时一张图合并为一条记录(一张图里可能有几只鸟),先写本地缓存、再同步后端,后端会生成「带编号标注框的全图 + 缩略图」。
二、推理服务:为什么从 torch 换成了 ONNX Runtime
第一版推理直接 YOLO(model.pt).predict(),功能没问题,但作为低流量云服务器服务,代价太难看:
- torch 方案:常驻内存 350~450MB,首次推理冷启动 4~9 秒,镜像还要塞 GB 级的 torch/ultralytics 依赖;
- ONNX Runtime 方案:常驻内存优化后 ~60MB,冷启动 0.5~1.5 秒,运行依赖只有几十 MB 的
onnxruntime。
说人话就是:模型还是那个模型,只是换了个更轻的「运行引擎」,推理结果可以做到几乎一致,部署负担小一个量级。
导出一次即可(固定输入尺寸、不带端到端 NMS):
from ultralytics import YOLO

model = YOLO("SwiftSight_1.0.pt")
out = model.export(
    format="onnx",
    imgsz=640,      # 固定尺寸导出,图更小、内存更低
    nms=False,      # CPU 场景自己写 NMS 更稳
    dynamic=False,  # 需要运行时切换尺寸(如 1280)才用 dynamic 导出
)最容易翻车的是输出格式约定:导出的 ONNX 输出是单张量 (1, 4+nc, N)(少数 ultralytics 版本为 (1, N, 4+nc)),前 4 通道是输入像素坐标下、未归一化的 xywh(中心点格式),其余是 200 个类别的得分。也就是说服务端要自己补齐一整条后处理:形状规整(兼容两种排布)→ 置信度阈值过滤(0.25)→ xywh 转 xyxy → 类别无关 NMS(IoU 0.7)→ 逆 letterbox 把框映射回原图坐标。NMS 用纯 numpy 写,几十行搞定,不用引额外依赖。
内存上还做了三件小事,实测收益都很大:
- 关闭 onnxruntime 的 CPU memory arena:这一项就把「会话 + 推理」常驻内存从 ~340MB 降到 ~60MB,推理还快了约 25%。原因是 arena 会把峰值激活内存一直攥着不还给系统;
- 懒加载(
MODEL_LAZY=1):启动时不建推理会话,第一个识别请求到了才按需加载,闲置内存回到纯 FastAPI 的 ~50~70MB; - 闲置自动卸载:后台看门狗每 30s 检查一次,距上次识别超过 120s 就卸载会话。卸载时除了
gc.collect(),还要调 glibcmalloc_trim(0)把空闲堆内存真还给操作系统——不调的话实测内存只降到 ~305MB,调完才能回到 ~70MB 基线。这个坑比较隐蔽,Linux 上有效,其他平台直接忽略即可。
健康检查接口也特意暴露了两个状态,方便运维区分「模型没配」和「会话没加载」:model_available(模型文件在不在)和 model_loaded(会话此刻有没有加载)。
三、踩坑 No.1:横屏照片全都识别错
上线后最典型的识别错误不是认错鸟,而是横屏/竖屏照片被当成转了 90° 的图。手机拍照的方向信息存在 EXIF 里,图片一旦经过压缩、重编码、裁剪工具处理,方向信息就很容易丢或写错。
解决方案是「前端 + 后端双层 EXIF 校正 + 方向探测」:
- 前端压缩时读取
wx.getImageInfo()的orientation,需要旋转就用离屏 canvas 校正后再导出——这一步能解决绝大多数正常照片; - 服务端再
ImageOps.exif_transpose()兜底一遍(新编码的 JPEG 通常已无方向信息,视为正向); - 仍救不回来的脏图,交给方向探测:先用低分辨率(最长边 640)跑一次 0°——大多数图这一步就有结果了,直接收工;0° 没有检出,才依次试 90/180/270°,一旦某个方向有检出就采纳,最后只在该方向上做一次全分辨率精识别。
# 1) 低分辨率快速探测方向(用 640 的图,成本很低)
best_angle, best_score = 0, -1.0
for angle in (0, 90, 180, 270):
    rotated = probe if angle == 0 else probe.transpose(_TRANSPOSES[angle])
    parsed = detector.predict(rotated, imgsz=640)
    score = sum(b["confidence"] for b in parsed.get("birds", [])) if parsed.get("success") else 0
    if score > best_score:
        best_score, best_angle = score, angle
    if best_score > 0:      # 当前方向已有检出,视为方向正确,停止探测
        break

# 2) 只在最可能的方向上做全分辨率精识别
rotated = image if best_angle == 0 else image.transpose(_TRANSPOSES[best_angle])
parsed = detector.predict(rotated, imgsz=FULL_IMGSZ)
方向转过 90/180/270° 的话,检测框坐标要映射回 0° 原图:把框的四个角点做反向旋转、再取外接矩形,避免框变形;如果识别前图片被缩放超过 1280,还要按比例把坐标还原到用户上传图的坐标系——前后端画标注框全靠这套坐标对齐。
这套策略的核心思路是:用一次 640 的廉价推理,换掉「每次傻傻跑 4 次全分辨率推理」,既救了横屏照片,又没把算力和延迟翻四倍。
四、200 个细分类,怎么变成用户看得懂的鸟
模型是在 CUB-200-2011 上训练的,能分 200 个细分类。但这里有两个现实问题:
- 用户不关心细分类学名,看到「某某莺 / 某某鹀」只会更懵;
- CUB 以北美鸟种为主,和洞庭湖区的物种交集有限,直接抛学名既不友好也不够准。
我的做法是软件层归并 + 资料层补充,全部用数据文件驱动、不写死在代码里:
species_list.yaml:200 个 class_id 与学名/英文名映射;species_groups.yaml:把细分类归并成国内通俗大类(各种「雀」归成「麻雀」一类,各种莺/鹀归到对应大类),每个大类配一句简介;bird_data.json:13 种有洞庭湖详细资料的鸟(习性、食性、栖息地、季节),按common_name(小写)匹配 CUB,命中就保留原名 + 完整资料,其余走大类名。
于是接口对所有检测结果都返回中文名:13 种重点鸟有图鉴级资料,其他至少能让用户判断「这属于什么大类、是不是保护鸟」。识别层和展示层解耦,将来换成湖区数据微调的模型,只动数据文件不动代码。
同一张图里有多只鸟时,约定是这样的:
- 每个检测实例都保留,同一物种两只鸟各自成框,不按类别合并;
- 只对位置几乎重合的框做类别无关去重(IoU > 0.5):一只鸟可能被两个相似细分类各检出一个框,这两个框合并、只留置信度高的——但真正分开的两只鸟必须都留着:
def deduplicate_overlaps(birds, iou_threshold=0.5):
    """类别无关去重:与任一已保留框 IoU 超过阈值则丢弃(按置信度倒序贪心)"""
    kept = []
    for bird in sorted(birds, key=lambda b: b["confidence"], reverse=True):
        bbox = bird.get("bbox") or []
        if len(bbox) < 4 or not any(_iou(bbox, k.get("bbox") or []) > iou_threshold for k in kept):
            kept.append(bird)
    return kept
保存记录时,后端用 PIL 在原图上画带编号的彩色标注框(编号和结果卡片一一对应),再压出全图(最长边 1280 / JPEG 85)和缩略图(最长边 400 / JPEG 70,不画框,列表页小图上画框太乱)。
五、识别记录:本地优先、云端备份、离线也能删
记录功能是最容易做乱的部分,我的设计目标是:秒开(不依赖网络)、离线可看可删、换设备不丢。
约定:一张图 = 一条记录,记录内是 birds[] 数组;摘要规则「单鸟返回鸟名,多鸟返回『首鸟名 等 N 只』」,前端后端各实现一份保持一致。
写入策略是「双写 + 回填」:
- 识别完先写本地:记录存 Storage(上限 50 条),图片存到
USER_DATA_PATH/records_images/,列表页秒开; - 再异步同步后端:SQLite 按
openid隔离,每用户上限 200 条; - 后端保存成功会回填
recordId,并把本地图片重命名成与后端一致的文件名({record_id}.jpg),这样本地缓存永远能命中,删除也能精确到后端 ID。
离线删除是我觉得最值得分享的细节:离线时删掉一条已同步的记录,本地先删,删除动作记进「待删除队列」,下次进记录页自动补删。队列里实际有三种场景:带后端 ID 的单删/批量删、「清空全部」标记、以及首页长按删除——后者当时只有 summary + 时间 没有 ID,所以补删时要先拉后端记录按「名称 + 归一化时间」匹配出 ID 再删(后端每用户最多 200 条,正好分两页、每页 100 拉全)。
反向的对账也要做:别人删了你的记录、后端超限清了旧记录,本地不能傻乎乎留着。每次进记录页以服务端为准核对一遍:已回填 recordId 但后端已不存在的本地记录,剔除并清理图片;拉取失败视为没网,保留缓存下次再对。
配额和删除的坑:
- 每用户 200 条记录 + 图片总字节上限 100MB,超了从最旧的开始清(连图片一起删);
- 批量删除的 SQL 要按 500 条一批分块执行——SQLite 单条 SQL 的变量数上限是 999,一次塞几千个占位符直接报错,这个不踩一次真想不到;
- 删除/清空后要同步删图片文件,删失败只记日志、不中断主流程。
六、微信登录与几个安全细节
识别接口无需登录(降低使用门槛),但识别记录是用户私有的。微信登录链路很常规:小程序 wx.login 拿 code → 后端调 jscode2session 换 openid → 发一个随机 token 建 7 天会话。几个容易忽略的细节:
- 数据库只存 token 的 SHA-256 哈希,不存明文,库泄露了 token 也不可逆推;
- 同一
openid只保留一个会话(新登录自动踢旧的),逻辑简单粗暴但够用; - 前端
request封装自动带Authorization头,收到 401 就强制重新登录并重试一次,登录 Promise 做了并发去重,多个请求同时 401 只触发一次wx.login:
def get_current_openid(authorization: str = Header(default="")) -> str:
    """从 Authorization: Bearer  提取 openid,未认证返回 401"""
    if not authorization.startswith("Bearer "):
        raise HTTPException(status_code=401, detail="未登录,请先授权登录")
    token = authorization[7:]
    openid = get_openid_by_token(token)
    if openid is None:
        raise HTTPException(status_code=401, detail="登录已过期,请重新登录")
    return openid
记录图片为什么用 ?token= 而不是 header? 因为小程序 <image> 组件没法带自定义 header,页面又要直接渲染后端图片,鉴权只能走 URL 查询参数。配套防御有:图片目录不挂 StaticFiles(否则等于公开目录);文件名必须属于该 token 用户的某条记录;用 resolve() 防路径穿越;校验失败统一返回 404 不暴露文件是否存在;文件名用 32 位随机 uuid4().hex,不可枚举。
上传安全也不复杂但都得有:上传字节上限 10MB(先 read(上限+1) 再判长度);全局限制 PIL.Image.MAX_IMAGE_PIXELS = 30_000_000,防「解压炸弹」(一张声明几十亿像素的图能让 PIL 解码时吃光内存);图片处理失败时不落盘原始字节,避免把带 EXIF 位置隐私的原图留在服务器;ALLOW_MOCK 默认关闭——模型文件缺失时识别接口返回 503,绝不用假数据糊弄用户。
七、测试、部署与小程序端三个编译限制
后端有 pytest 测试套件(数据库 CRUD/分页、检测结果解析、目录加载、摘要规则),测试用临时库,不污染真实数据。Docker 镜像只装 Python 依赖,源码和模型文件运行时卷挂载注入,换模型不用重建镜像。
小程序端则是一堆「真机才发作」的编译限制,比较有代表性的三条:
- WXML 表达式能力极弱:
{{}}里不能写.toFixed()、.slice()、.includes()。所有展示值必须在.ts里算好再setData(),比如置信度百分比、日期标签; - TS 兼容性按真机最低标准写:未开启 enhance 编译时
??不可用(判空统一写!= null),对象展开{...obj}编译有问题(统一Object.assign({}, obj, {...})); - Skyline 下离屏 canvas 的
img.onload可能不触发:方向校正依赖 canvas 旋转,真机上偶发卡死,最后给img.onload加了 5 秒超时兜底——超时直接回落原图,宁可方向不对也不让流程卡死。
八、坦白局:模型的局限
诚实地讲,这套系统最薄弱的环节在最上游的模型:CUB-200-2011 以北美鸟种为主,和洞庭湖物种重合有限。目前的「细分类 → 通俗大类」归并和资料层是在软件层面尽量兜底,让大众场景不出离谱结果,但它替代不了真正的湖区本地模型。
后续计划是:用湖区实地拍摄数据(巡护台账、博物馆影像)微调或重训模型;给保护鸟类做分级提示(认出来之后告诉用户怎么处置、向谁举报);再往后是农户最关心的「鸟类活动预警」。如果下一版模型落地了,我再写一篇训练侧的文章。
写在最后
硬要总结的话就一句话:这类「识别」项目的难点从来不在模型本身,而在把模型放进一个真实、低配、必须靠谱的闭环里——图片方向、中文名映射、双端一致、配额与鉴权、平台兼容,每一项单独看都不难,串起来才是一个能被人天天用的小工具。
相关链接:
- 项目官网(宣传页 + 体验入口):https://bird.hnist.org.cn
- 项目代码目前暂未开源;如果你也在做类似的小程序 + YOLO 项目,欢迎评论区交流。